MyCat Installation and Usage
一、MyCat的安装
1、环境准备
本次课程Usage的Virtual Machine环境是centos6.5,首先准备四台Virtual Machine,Installation好mysql,方便后续做Read-Write Separation和Master-Slave Replication。
192.168.85.111 node01
192.168.85.112 node02
192.168.85.113 node03
192.168.85.114 node04 Installationjdk
Usagerpm的方式直接Installationjdk,Configuration好具体的环境变量
2、安装
从官网Download需要的Installation包,并且上传到具体的Virtual Machine中,我们在Usage的时候将包上传到node01这台Virtual Machine,由node01充当MyCat。
Download地址为:http://dl.mycat.org.cn/1.6.7.5/2020-4-10/
解压File到/usr/localFile夹下
tar -zxvf Mycat-server-1.6.7.5-release-20200422133810-linux.tar.gz -C /usr/localConfiguration环境变量
vi /etc/profile
添加如下配置信息:
export MYCAT_HOME=/usr/local/mycat
export PATH=$MYCAT_HOME/bin:$PATH:$JAVA_HOME/bin
当Execute到这步的时候,其实就可以Start了,但是为了能正确显示出效果,最好修改下MyCat的具体Configuration,让我们能够正常进行访问。
3、配置MyCat
进入到/usr/local/mycat/confDirectory下,修改该File夹下的Configuration File
1、修改server.xmlFile
<?xml version="1.0" encoding="UTF-8"?>
<!-- - - Licensed under the Apache License, Version 2.0 (the "License");
	- you may not use this file except in compliance with the License. - You
	may obtain a copy of the License at - - http://www.apache.org/licenses/LICENSE-2.0
	- - Unless required by applicable law or agreed to in writing, software -
	distributed under the License is distributed on an "AS IS" BASIS, - WITHOUT
	WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied. - See the
	License for the specific language governing permissions and - limitations
	under the License. -->
<!DOCTYPE mycat:server SYSTEM "server.dtd">
<mycat:server xmlns:mycat="http://io.mycat/">
	<user name="root" defaultAccount="true">
		<property name="password">123456</property>
		<property name="schemas">TESTDB</property>
		<property name="defaultSchema">TESTDB</property>
	</user>
</mycat:server>
2、修改schema.xmlFile
<?xml version="1.0"?>
<!DOCTYPE mycat:schema SYSTEM "schema.dtd">
<mycat:schema xmlns:mycat="http://io.mycat/">
        <schema name="TESTDB" checkSQLschema="false" sqlMaxLimit="100" dataNode="dn1">
        </schema>
        <dataNode name="dn1" dataHost="host1" database="msb" />
        <dataHost name="host1" maxCon="1000" minCon="10" balance="0"
                          writeType="0" dbType="mysql" dbDriver="native" switchType="1"  slaveThreshold="100">
                <heartbeat>select user()</heartbeat>
                <writeHost host="hostM1" url="192.168.85.111:3306" user="root"
                                   password="123456">
                        <readHost host="hostS1" url="192.168.85.112:3306" user="root" password="123456"></readHost>
                </writeHost>
        </dataHost>
</mycat:schema>
4、启动mycat
mycat的Start有两种方式,一种是控制台Start,一种是后台Start,在初学的时候建议大家Usage控制台Start的方式,当Configuration File写错之后,可以方便的看到Error,及时修改,但是在生产环境中,Usage后台Start的方式比较稳妥。
控制台Start:去mycat/binDirectory下Execute ./mycat console
后台Start:去mycat/binDirectory下Execute ./mycat start
按照如上Configuration在Installation的时候应该不会Error,如果出现Error,根据Error的提示解决即可。
5、登录验证
管理窗口的登录
从另外的Virtual Machine去登录访问当前MyCat,输入如下Command即可
mysql -uroot -p123456 -P 9066 -h 192.168.85.111 此时访问的是MyCat的管理窗口,可以通过show @@helpView可以Execute的Command
Data窗口的登录
从另外的Virtual Machine去登录访问MyCat,输入Command如下:
mysql -uroot -p123456 -P8066 -h 192.168.85.111 当都能够成功的时候以为着mycat已经搭建完成。
二、读写分离
通过MyCat和MySQL的Master-Slave Replication配合搭建Database的Read-Write Separation,可以ImplementationMySQL的High Availability性,下面我们来搭建MySQl的Read-Write Separation。
1、一主一从(主从复制的原理之前讲解过了,需要的同学自行参阅文档)
1、在node01上修改/etc/my.cnf的File
#mysql服务唯一id,不同的mysql服务必须拥有全局唯一的id
server-id=1
#启动二进制日期
log-bin=mysql-bin
#设置不要复制的数据库
binlog-ignore-db=mysql
binlog-ignore-db=information-schema
#设置需要复制的数据库
binlog-do-db=msb
#设置binlog的格式
binlog_format=statement
2、在node02上修改/etc/my.cnfFile
#服务器唯一id
server-id=2
#启动中继日志
relay-log=mysql-relay
3、重新StartmysqlService
4、在node01上Create账户并授权slave
grant replication slave on *.* to 'root'@'%' identified by '123456';
--在进行授权的时候,如果提示密码的问题,把密码验证取消
set global validate_password_policy=0;
set global validate_password_length=1;
5、Viewmaster的状态
show master status6、在node02上Configuration需要复制的主机
CHANGE MASTER TO MASTER_HOST='192.168.85.111',MASTER_USER='root',MASTER_PASSWORD='123456',MASTER_LOG_FILE='mysql-bin.000001',MASTER_LOG_POS=437;7、Start从Server复制功能
start slave;8、View从Server状态
show slave status\G 当Execute完成之后,会看到两个关键的属性Slave_IO_Running,Slave_SQL_Running,当这两个属性都是yes的时候,表示Master-Slave Replication已经准备好了,可以进行具体的操作了
2、一主一从验证
下面我们通过实际的操作来VerificationMaster-Slave Replication是否完成。
--在node01上创建数据库
create database msb;
--在node01上创建具体的表
create table mytbl(id int,name varchar(20));
--在node01上插入数据
insert into mytbl values(1,'zhangsan');
--在node02上验证发现数据已经同步成功,表示主从复制完成 通过MyCatImplementationRead-Write Separation
在node01上插入如下sql语句,
-- 把主机名插入数据库中
insert into mytbl values(2,@@hostname);
-- 然后通过mycat进行数据的访问,这个时候大家发现无论怎么查询数据,最终返回的都是node01的数据,为什么呢?
select * from mytbl; 在之前的mycat基本Configuration中,其实我们已经Configuration了Read-Write Separation,大家还记得readHost和writeHost两个标签吗?
<writeHost host="hostM1" url="192.168.85.111:3306" user="root"
				   password="123456">
			<readHost host="hostS1" url="192.168.85.112:3306" user="root" password="123456"></readHost>
</writeHost> 其实我们已经Configuration过了这两个标签,默认情况下node01是用来完成写入操作的,node02是用来完成读取操作的,但是刚刚通过我们的Verification发现所有的读取都是node01完成的,这是什么原因呢?
原因很简单,就是因为我们在进行Configuration的时候在 dataHost 标签中缺失了一个非常重要的属性balance,此属性有四个值,用来做Load Balancing的,下面我们来详细介绍
1、balance=0 :不开启Read-Write SeparationMechanism,所有读操作都发送到当前可用的writehost上
2、balance=1:全部的readhost和stand by writehost参与select 语句的Load Balancing,简单的说,当双主双从Pattern下,其他的节点都参与select语句的Load Balancing
3、balance=2:所有读操作都随机的在writehost,readhost上分发
4、balance=3:所有读请求随机的分发到readhostExecute,writehost不负担读压力
当Understand了这个Parameter的含义之后,我们可以将此ParameterSettings为2,就能够看到在两个主机上切换Execute了。
3、双主双从
在上述的一主一从的Architecture Design中,很容易出现单点的Problem,所以我们要想让生产环境中的Configuration足够稳定,可以Configuration双主双从,解决单点的Problem。
架构图如下所示:
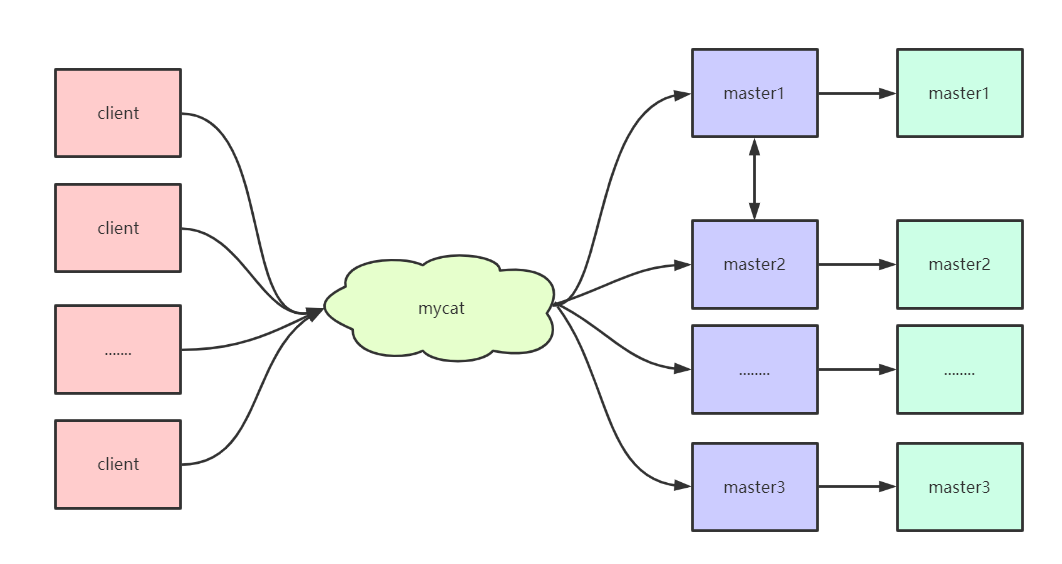
在此架构中,可以让一台主机用来处理所有写请求,此时,它的从机和备机,以及备机的从机复制所有读请求,当主机宕机之后,另一台主机负责写请求,两台主机互为备机。
主机分布如下:
| 编号 | 角色 | ip | 主机名 |
|---|---|---|---|
| 1 | master1 | 192.168.85.111 | node01 |
| 2 | slave1 | 192.168.85.112 | node02 |
| 3 | master2 | 192.168.85.113 | node03 |
| 4 | slave2 | 192.168.85.114 | node04 |
下面开始搭建双主双从。
1、修改node01上的/etc/my.cnfFile
#主服务器唯一ID
server-id=1
#启用二进制日志
log-bin=mysql-bin
# 设置不要复制的数据库(可设置多个)
binlog-ignore-db=mysql
binlog-ignore-db=information_schema
#设置需要复制的数据库
binlog-do-db=msb
#设置logbin格式
binlog_format=STATEMENT
# 在作为从数据库的时候, 有写入操作也要更新二进制日志文件
log-slave-updates
#表示自增长字段每次递增的量,指自增字段的起始值,其默认值是1, 取值范围是1 .. 65535
auto-increment-increment=2
# 表示自增长字段从哪个数开始,指字段一次递增多少,他的取值范围是1 .. 65535
auto-increment-offset=1 2、修改node03上的/etc/my.cnfFile
#主服务器唯一ID
server-id=3
#启用二进制日志
log-bin=mysql-bin
# 设置不要复制的数据库(可设置多个)
binlog-ignore-db=mysql
binlog-ignore-db=information_schema
#设置需要复制的数据库
binlog-do-db=msb
#设置logbin格式
binlog_format=STATEMENT
# 在作为从数据库的时候,有写入操作也要更新二进制日志文件
log-slave-updates
#表示自增长字段每次递增的量,指自增字段的起始值,其默认值是1,取值范围是1 .. 65535
auto-increment-increment=2
# 表示自增长字段从哪个数开始,指字段一次递增多少,他的取值范围是1 .. 65535
auto-increment-offset=2 3、修改node02上的/etc/my.cnfFile
#从服务器唯一ID
server-id=2
#启用中继日志
relay-log=mysql-relay 4、修改node04上的/etc/my.cnfFile
#从服务器唯一ID
server-id=4
#启用中继日志
relay-log=mysql-relay 5、所有主机重新StartmysqlService
6、在两台主机node01,node03上授权SynchronizationCommand
GRANT REPLICATION SLAVE ON *.* TO 'root'@'%' IDENTIFIED BY '123456'; 7、View两台主机的状态
show master status; 8、在node02上Execute要复制的主机
CHANGE MASTER TO MASTER_HOST='192.168.85.111',MASTER_USER='root',MASTER_PASSWORD='123456',MASTER_LOG_FILE='mysql-bin.000001',MASTER_LOG_POS=154; 9、在node04上Execute要复制的主机
CHANGE MASTER TO MASTER_HOST='192.168.85.113',MASTER_USER='root',MASTER_PASSWORD='123456',MASTER_LOG_FILE='mysql-bin.000001',MASTER_LOG_POS=154; 10、Start两个从机的slave并且View状态,当看到两个Parameter都是yes的时候表示成功
start slave;
show slave status; 11、完成node01跟node03的相互复制
--在node01上执行
CHANGE MASTER TO MASTER_HOST='192.168.85.113',MASTER_USER='root',MASTER_PASSWORD='123456',MASTER_LOG_FILE='mysql-bin.000001',MASTER_LOG_POS=442;
--开启slave
start slave
--查看状态
show slave status\G
--在node03上执行
CHANGE MASTER TO MASTER_HOST='192.168.85.111',MASTER_USER='root',MASTER_PASSWORD='123456',MASTER_LOG_FILE='mysql-bin.000002',MASTER_LOG_POS=442;
--开启slave
start slave
--查看状态
show slave status\G
4、双主双从验证
在node01上Execute如下sql语句:
create database msb;
create table mytbl(id int,name varchar(20));
insert into mytbl values(1,'zhangsan');
--完成上述命令之后可以去其他机器验证是否同步成功 当上述操作完成之后,我们可以Verificationmycat的Read-Write Separation,此时我们需要进行重新的Configuration,修改schema.xmlFile。
在当前mysql架构中,我们Usage的是双主双从的架构,因此可以将balanceSettings为1
除此之外我们需要注意,还需要Understand一些Parameter:
ParameterwriteType,表示写操作发送到哪台机器,此Parameter有两个值可以进行Settings:
writeType=0:所有写操作都发送到Configuration的第一个writeHost,第一个挂了切换到还生存的第二个
writeType=1:所有写操作都随机的发送到Configuration的writehost中,1.5之后废弃,
需要注意的是:writehost重新Start之后以切换后的为准,切换记录在Configuration Filednindex.properties中
ParameterswitchType:表示如何进行切换:
switchType=1:默认值,自动切换
switchType=-1:表示不自动切换
switchType=2:基于mysql主从Synchronization的状态决定是否切换
<?xml version="1.0"?>
<!DOCTYPE mycat:schema SYSTEM "schema.dtd">
<mycat:schema xmlns:mycat="http://io.mycat/">
	<schema name="TESTDB" checkSQLschema="false" sqlMaxLimit="100" dataNode="dn1">
	</schema>
	<dataNode name="dn1" dataHost="host1" database="msb" />
	<dataHost name="host1" maxCon="1000" minCon="10" balance="1"
			  writeType="0" dbType="mysql" dbDriver="native" switchType="1"  slaveThreshold="100">
		<heartbeat>select user()</heartbeat>
		<writeHost host="hostM1" url="192.168.85.111:3306" user="root"
				   password="123456">
			<readHost host="hostS1" url="192.168.85.112:3306" user="root" password="123456"></readHost>
		</writeHost>
		<writeHost host="hostM2" url="192.168.85.113:3306" user="root"
				   password="123456">
			<readHost host="hostS2" url="192.168.85.114:3306" user="root" password="123456"></readHost>
		</writeHost>
	</dataHost>
</mycat:schema> 下面开始进行Read-Write Separation的Verification
--插入以下语句,使数据不一致
insert into mytbl values(2,@@hostname);
--通过查询mycat表中的数据,发现查询到的结果在node02,node03,node04之间切换,符合正常情况
select * from mytbl;
--停止node01的mysql服务
service mysqld stop
--重新插入语句
insert into mytbl values(3,@@hostname);
--开启node01的mysql服务
service mysqld start
--执行相同的查询语句,此时发现在noede01,node02,node04之间切换,符合情况 通过上述的Verification,我们可以得到一个结论,node01,node03互做备机,负责写的宕机切换,其他机器充作读请求的响应。
做到此处,希望大家能够思考一个Problem,在上述我们做的Read-Write Separation操作,其实都是基于Master-Slave Replication的,也就是Data Synchronization,但是在生产环境中会存在很多种情况造成Master-Slave Replication延迟Problem,那么我们应该如何解决延迟Problem,这是一个值得思考的Problem,到底如何解决呢?
三、数据切分
Data切分指的是通过某种特定的条件,将我们存放在同一个Database中的Data分散存放到多个Database上面,以达到分散单台设备负载的效果。
Data的切分根据其切分规则的Type,可以分为两种切分Pattern。一种是按照不同的表来切分到不同的Database之上,这种切可以称之为Data的垂直切分或者纵向切分,另外一种则是根据表中的Data的逻辑关系,将同一个表中的Data按照某种条件拆分到多台Database上面,这种切分称之为Data的水平切分或者横向切分。
垂直切分的最大特点就是 规则简单,实施也更为方便,尤其适合各业务之间的耦合度非常低,相互影响很小,业务逻辑非常清晰的系统。在这种系统中,可以很容易做到将不同业务模块所Usage的表分拆到不同的Database中。根据不同的表来进行拆分,对应用程序的影响也很小,拆分规则也会比较简单清晰。
水平切分与垂直切分相比,相对来说稍微复杂一些。因为要将同一个表中的不同Data拆分到不同的Database中,对于应用程序来说,拆分规则本身就较根据表明来拆分更为复杂,后期的Data维护也会更为复杂一些。
1、垂直切分
一个Database由很多表的构成,每个表对应着不同的业务,垂直切分是指按照业务将表进行分类,分布到不同的Database上面,这样也就将Data或者压力分担到不同的Library上面。
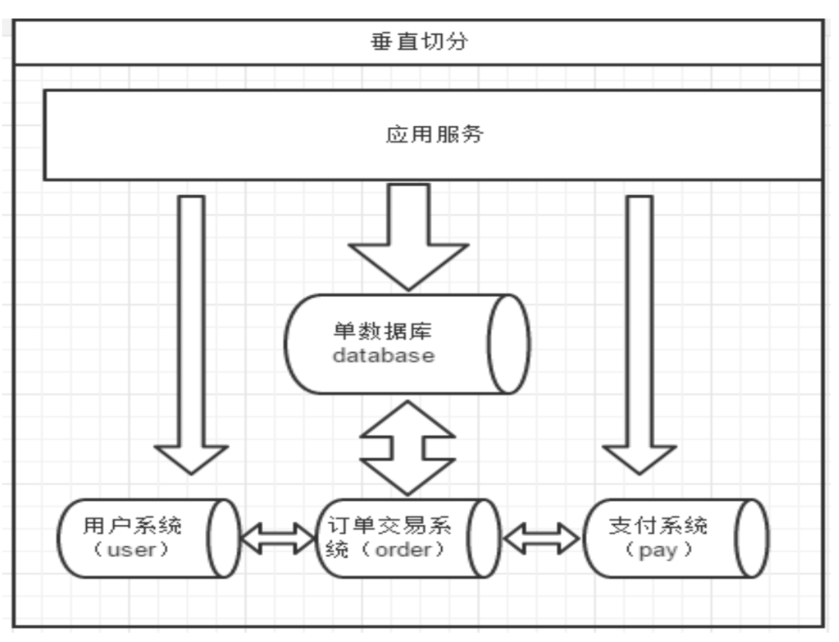
如上图所示,一个系统被切分成了用户系统、订单交易、支付系统等多个Library。
一个Architecture Design较好的应用系统,其总体功能肯定是又多个功能模块所组成的。而每一个功能模块所需要的Data对应到Database中就是一个或者多个表。而在Architecture Design中,各个功能模块相关质检的交互点越统一越少,系统的耦合度就越低,系统各个模块的维护性以及扩展性也就越好。这样的系统,ImplementationData的垂直切分也就越容易。
但是往往系统中有些表难以做到完全的独立,存在着跨Libraryjoin的情况,对于这类的表,就需要去做平衡,是Data让步业务,共用一个Data源还是分成多个Library,业务之间通过Interface来做调用。在系统初期,Data量比较少,或者资源有限的情况下,会Choose共用Data源,但是当Data发展到一定规模,负载很大的情况下就必须要做分割。
一般来讲业务存在着复杂join的场景是难以切分的,往往业务独立的易于切分。如何切分,切分到何种程度是考验技术架构的一个难题。下面来分析下垂直切分的优缺点:
优点:
1、拆分后业务清晰,拆分规则明确
2、系统之间整合或扩展容易
3、Data维护简单
缺点:
1、部分业务表无法Implementationjoin,只能通过Interface方式解决,提高了系统复杂度
2、受每种业务不同的限制存在单LibraryPerformance瓶颈,不易Data扩展跟Performance提高
3、Transaction处理复杂
2、水平切分
相对于垂直拆分,水平拆分不是将表做分类,而是按照某个字段的某种规则来分散到多个Library中,每个表中包含一部分Data。简单来说,我们可以将Data的水平切分理解为是按照Data行切分,就是将表中的某些行切分到一个Database,而另外的某些行又切分到其他的Database中,
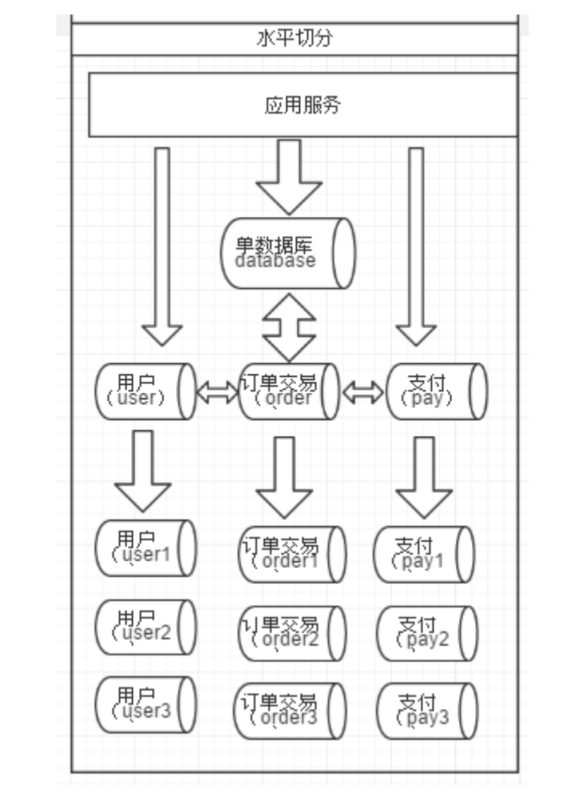
拆分Data就需要定义分片规则。关系型Database是行列的二维模型,拆分的第一原则是找到拆分维度。比如从会员的角度来分析,商户订单交易类系统中查询会员某天某月某个订单,那么就需要按照会员结合日期来拆分,不同的Data按照会员id做分组,这样所有的Data查询join都会在单Library内解决;如果从商户的角度来讲,要查询某个商家某天所有的订单数,就需要按照商户id做拆分;但是如果系统既想按照会员拆分,又想按照商家Data拆分,就会有一定的困难,需要综合考虑找到合适的分片。
几种典型的分片规则包括:
1、按照用户id取模,将Data分散到不同的Database,具有相同Data用户的Data都被分散到一个Library中;
2、按照日期,将不同月甚至日的Data分散到不同的Library中;
3、按照某个特定的字段求模,或者根据特定范围段分散到不同的Library中。
如图,切分原则都是根据业务找到适合的切分规则分散到不同的Library,下图是用用户id求模的案例:
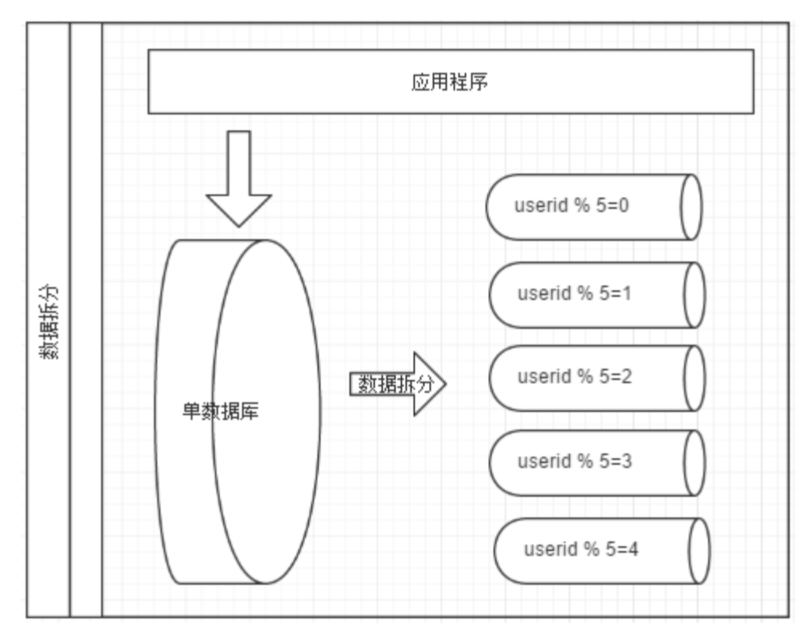
Data做完了水平拆分之后也是有优缺点的。
优点:
1、拆分规则抽象好,join操作基本可以Database做;
2、不存在单LibraryBig Data,高Concurrency的Performance瓶颈;
3、应用端改造较少;
4、提高了系统的稳定性跟负载能力
缺点:
1、拆分规则难以抽象
2、分片Transaction一致性难以解决
3、Data多次扩展跟维护量极大
4、跨LibraryjoinPerformance较差
3、总结
Data切分的两种方式,会发现每种方式都有自己的缺点,但是他们之间有共同的缺点,分别是:
1、引入了Distributed Transaction的Problem
2、跨节点join的Problem
3、跨节点合并Sorting分页的Problem
4、多Data源管理的Problem
针对Data源管理,目前主要有两种思路:
1、客户端Pattern,在每个应用程序模块中Configuration管理自己需要的一个或多个Data源,直接访问各个Database,在模块内完成Data的整合
2、通过中间Proxy层来统一管理所有的Data源,后端Database集群对前端应用程序透明;
在实际的生产环境中,我们都会Choose第二种方案来解决Problem,尤其是系统不断变得庞大复杂的时候,其实这是非常正确的,虽然短期内付出的成本可能会比较大,但是对整个系统的扩展性来说,是非常有帮助的。
MyCat通过Data切分解决传统Database的缺陷,又有了nosql易于扩展的优点。通过中间Proxy层规避了多Data源的DataProblem,对应用完全透明,同时对Data切分后存在的Problem,也做了Solution。
MyCat在做Data切分的时候应该尽可能的遵循以下原则,当然这也是经验之谈,最终的落地Implementation还是要看具体的应用场景在做具体的分析
第一原则:能不切分尽量不要切分
第二原则:如果要切分一定要Choose合适的切分规则,提前规划好
第三原则:Data切分尽量通过Data冗余或表分组来降低跨Libraryjoin的可能
第四原则:由于Database中间件对DatajoinImplementation的优劣难以把握,而且Implementation高Performance难度极大,业务读取尽量少Usage多表join。
四、MyCat的配置文件讲解
在之前的操作中,我们已经做了部分File的Configuration,但是具体的属性并没有讲解,下面我们讲解下每一个Configuration File具体的属性以及相关的基本Configuration。
1、搞定schema.xml文件
schema.xml作为MyCat中重要地Configuration File之一,管理着MyCat的逻辑Library、表、分片规则、DataNode以及DataSource。
1、schema标签
<schema name="TESTDB" checkSQLschema="false" sqlMaxLimit="100" dataNode="dn1"></schema> schema标签用于定义MyCatExample中的逻辑Library,MyCat可以有多个逻辑Library,每个逻辑Library都有自己相关的Configuration,可以Usageschema标签来划分这些不同的逻辑Library。如果不Configurationschame,那么所有的表Configuration都将属于同一个默认的逻辑Library。
**dataNode:**该属性用于绑定逻辑Library到某个具体的database上。
**checkSQLschema:**当该值为true时,如果Executeselect * from TESTDB.user,那么MyCat会将语句修改为select * from user,即把表示schema的字符去掉,避免发送到后端DatabaseExecute时Error。
**sqlMaxLimit:**当该值Settings为某个数值的时候,每次Execute的sql语句,如果没有加上limit语句,MyCat也会自动加上对应的值。例如,当Settings值为100的时候,那么select * from user的效果跟Executeselect * from user limit 100相同。如果不Settings该值的话,MyCat默认会把所有的Data信息都查询出来,造成过多的输出,所以,还是建议Settings一个具体的值,以减少过多的DataReturn。当然sql语句中可以显式的制定limit的大小,不受该属性的Constraints。
2、table标签
<table name="travelrecord" dataNode="dn1,dn2,dn3" rule="auto-sharding-long" ></table> table标签定义了MyCat中的逻辑表,所有需要拆分的表都需要在这个标签中定义。
**name:**定义逻辑表的表名,这个名字就如同Create表的时候指定的表名一样,同个schema标签中定义的名字必须唯一。
**dataNode:**定义这个逻辑表所属的dataNode,该属性的值需要和dataNode标签中的name属性值对应,如果需要定义的dn过多,可以Usage如下Method减少Configuration:
<table name="travelrecord" dataNode="multipleDn$0-99,multipleDn2$100-199" rule="auto-shardinglong" ></table>
<dataNode name="multipleDn$0-99" dataHost="localhost1" database="db$0-99" ></dataNode>
<dataNode name="multipleDn2$100-199" dataHost="localhost1" database=" db$100-199" ></dataNode> **rule:**该属性用于指定逻辑表要Usage的规则名字,规则名字在rule.xml中定义,必须与tableRule标签中的name属性值一一对应
**ruleRequired:**该属性用于指定表是否绑定分片规则,如果Configuration为true,但没有Configuration具体rule的话,程序会Error。
**primaryKey:**该逻辑表对应真实表的主键,例如:分片的规则是Usage非主键进行分片的,那么在Usage主键查询的时候,就会发送查询语句到所有Configuration的DN上,如果Usage改属性Configuration真实表的主键。那么MyCat会Cache主键与具体DN的信息,那么再次Usage非主键进行查询的时候就不会进行广播式的查询,就会直接发送语句到具体的DN,但是尽管Configuration改属性,如果Cache没有命中的话,还是会发送语句给具体的DN来获得Data
**type:**该属性定义了逻辑表的Type,目前逻辑表只有全局表和普通表两种Type。对应的Configuration:
全局表:global
普通表:不指定该值为global的所有表
**autoIncrement:**MySQL 对非自增长主键,Usage last_insert_id()是不会Return结果的,只会Return 0。所以,只有定义了自增长主键的表才可以用 last_insert_id()Return主键值。MyCat目前提供了自增长主键功能,但是如果对应的MySQL节点上Data表,没有定义 auto_increment,那么在MyCat层调用 last_insert_id()也是不会Return结果的。由于 insert 操作的时候没有带入分片键, MyCat 会先取下这个表对应的全局序列,然后赋值给分片键。 这样才能正常的插入到Database中,最后Usage last_insert_id()才会Return插入的分片键值。如果要Usage这个功能最好配合UsageDatabasePattern的全局序列。Usage autoIncrement=“true” 指定这个表有Usage自增长主键,这样 MyCat才会不抛出分片键找不到的异常。Usage autoIncrement=“false” 来禁用这个功能,当然你也可以直接删除掉这个属性。默认就是禁用的。
**needAddLimit:**指定表是否需要自动的在每个语句后面加上limit限制。由于Usage了分Library分表,Data量有时会特别巨大。这时候Execute查询语句,如果恰巧又忘记了加上数量限制的话,那么查询所有的Data出来,就会Execute很久的时间,所以mycat自动为我们加上了limit 100。当前如果语句中又limit,那么就不会添加了。
3、childTable标签
childTable标签用于定义ER分片的子表。通过标签上的属性与父表进行关联。
**name:**定义子表的表名
**joinKey:**插入子表的时候会Usage这个列的值查找父表Storage的Data节点
**parentKey:**属性指定的值一般为与父表建立关联关系的列名。程序首先Getjoinkey的值,再通过parentKey属性指定的列名产生查询语句,通过Execute该语句得到父表Storage再哪个分片上,从而确定子表Storage的位置。
**primaryKey:**跟table标签所描述相同
**needAddLimit:**跟table标签所描述相同
4、dataNode标签
<dataNode name="dn1" dataHost="lch3307" database="db1" ></dataNode> dataNode标签定义了mycat中的Data节点,也就是我们通常说的Data Sharding,一个dataNode标签就是一个独立的Data Sharding。
**name:**定义Data节点的名字,这个名字需要是唯一的,我们需要再table标签上应用这个名字,来建立表与分片对应的关系
**dataHost:**该属性用于定义该分片属于哪个DatabaseExample,属性值是引用dataHost标签上定义的name属性。
**database:**该属性用于定义该分片属性哪个具体Database实力上的具体Library,
5、dataHost标签
该标签定义了具体的DatabaseExample、Read-Write SeparationConfiguration和心跳语句
<dataHost name="localhost1" maxCon="1000" minCon="10" balance="0"
writeType="0" dbType="mysql" dbDriver="native">
<heartbeat>select user()</heartbeat>
<!-- can have multi write hosts -->
<writeHost host="hostM1" url="localhost:3306" user="root"
password="123456">
<!-- can have multi read hosts -->
<!-- <readHost host="hostS1" url="localhost:3306" user="root" password="123456"
/> -->
</writeHost>
<!-- <writeHost host="hostM2" url="localhost:3316" user="root" password="123456"/> -->
</dataHost> **name:**唯一标识dataHost标签,供上层的标签Usage
**maxcon:**指定每个读写ExampleConnection Pool的最大连接
**mincon:**指定每个读写Example连接Connection Pool的最小链接,初始化Connection Pool的大小
**balance:**Load BalancingType:
0:不开启Read-Write SeparationMechanism,所有读操作都发送到当前可用的writeHost上
1:全部的readHost和stand by writeHost参与select语句的Load Balancing,简单的说,当双主双从Pattern(M1->S1,M2->S2,并且M1与M2互为主备),正常情况下,M2,S1,S2都参与select语句的Load Balancing
2:所有读操作都随机的再writeHost、readHost上分发
3:所有读请求随机的分发到writeHost对应readHostExecute,writeHost不负担读压力,在之后的Version中失效。
**writeType:**写Type
writeType=0:所有的写操作发送到Configuration的第一个writeHost,第一个挂了切换到还生存的第二个writeHost,Restart之后以切换后的为准,切换记录保存在Configuration File dnindex.properties
writeType=1:所有写操作都随机的发送到Configuration的writeHost,1.5以后废弃不推荐
**dbType:**指定后端连接的DatabaseType,如MySQL,mongodb,oracle
**dbDriver:**指定连接后端DatabaseUsage的Driver,目前可选的值有native和JDBC。Usagenative的话,因为这个值Execute的是二进制的mysql协议,所以可以Usagemysql和maridb,其他Type的Database则需要UsageJDBC驱动来支持。
**switchType:**是否进行主从切换
-1:表示不自动切换
1:默认值,自动切换
2:基于mysql主从Synchronization的状态决定是否切换
6、heartbeat标签
这个标签指明用于和后端Database进行Heartbeat Detection的语句。
2、搞定server.xml文件
server.xml几乎保存了所有mycat需要的系统Configuration信息。
<user name="test">
<property name="password">test</property>
<property name="schemas">TESTDB</property>
<property name="schemas">TESTDB</property>
<property name="schemas">TESTDB</property>
<property name="schemas">TESTDB</property>
<privileges check="false">
    <schema name="TESTDB" dml="0010" showTables="custome/mysql">
        <table name="tbl_user" dml="0110"></table>
        <table name="tbl_dynamic" dml="1111"></table>
    </schema>
    </privileges>
</user> server.xml中的标签本就不多,这个标签主要用于定义登录mycat的用户和Permissions。
property标签用来声明具体的属性值,name用来指定用户名,password用来修改密码,readonly用来限制用户是否是只读的,schemas用来控制用户课访问的schema,如果有多个的话,用逗号分隔
privileges标签是对用户的schema及下级的table进行精细化的DML控制,privileges节点的check属性适用于标识是否开启DMLPermissions检查,默认false标识不检查,当然不Configuration等同于不检查
在进行检查的时候,是通过四个二进制位来标识的,insert,update,select,delete按照顺序标识,0表示未检查,1表示要检查
system标签表示系统的相关属性:
| 属性 | 含义 | 备注 |
|---|---|---|
| charset | 字符集Settings | utf8,utf8mb4 |
| defaultSqlParser | 指定的默认Analysis器 | druidparser,fdbparser(1.4之后作废) |
| processors | 系统可用的Thread数, | 默认为机器CPU核心Thread数 |
| processorBufferChunk | 每次分配socket direct buffer的大小 | 默认是4096个字节 |
| processorExecutor | 指定NIOProcessor共享的businessExecutor固定Thread Pool大小,mycat在处理Asynchronous逻辑的时候会把任务提交到这个Thread Pool中 | |
| sequnceHandlerType | mycat全局序列的Type | 0为本地File,1为Database方式,2为时间戳方式,3为DistributedZK ID生成器,4为zk递增id生成 |
3、rule.xml
rule.xml里面就定义了我们对表进行拆分所涉及到的规则定义。我们可以灵活的对表Usage不同的分片算法,或者对表Usage相同的算法但具体的Parameter不同,这个File里面主要有tableRule和function这两个标签。
1、tableRule
这个标签被用来定义表规则,定义的表规则在schema.xmlFile中
<tableRule name="rule1">
    <rule>
    	<columns>id</columns>
        <algorithm>func1</algorithm>
    </rule>
</tableRule> name属性指定唯一的名字,用来标识不同的表规则
内嵌的rule标签则指定对物理表中的哪一列进行拆分和Usage什么路由算法
columns内指定要拆分的列的名字
algorithmUsagefunction标签中的那么属性,连接表规则和具体路由算法。当然,多个表规则可以连接到同一个路由算法上。
2、function
<function name="hash-int" class="io.mycat.route.function.PartitionByFileMap">
    <property name="mapFile">partition-hash-int.txt</property>
</function> name指定算法的名字
class指定路由算法具体的类名字
property为具体算法需要用到的一些属性