MyCat Introduction and Installation
MyCat
一、基础知识
1、分布式系统
Distributed系统是指其组件分布在网络上,组件之间通过传递Message进行通信和动作协调的系统。它的核心理念是让多台Server协同工作,完成单台Server无法处理的任务,尤其是高Concurrency或者Big Data量的额任务。它的特点是:
**透明性:**Distributed系统对于用户是透明的,一个Distributed系统在用户面前的表现就像一个传统的单处理机分时系统,可用用户不必Understand其内部结构就能Usage;
**扩展性:**Distributed系统的最大特点是可扩展性,它能够根据需求的增加而扩展,可以通过横向扩展使集群的整体Performance得到线性提升,也可以通过纵向扩展单台Server的Performance使Server集群的Performance得到提升;
**可靠性:**Distributed系统不允许单点失效的Problem存在,它的基本思想是,如果一台机器坏了,则其他机器能够接替它进行工作,具有持续Service的Features;
**高Performance:**高Performance才是DesignDistributed系统的初衷.
Distributed系统的缺点:
1、在节点通信部分的开销比较大,ThreadSafetyProblem也变得复杂,需要在保证Data完整性的同时兼顾Performance
2、过分Dependency网络,网络信息的Lost和饱和将会抵消Distributed系统的大部分优势
3、有潜在的DataSafety和Network Security等Safety性Problem。
2、分布式数据库
随着技术的发展,各个行业所产生的Data量呈爆炸式增长,动辄就达到数百TB或者PB的级别,已经远远超过了传统单机Database的处理能力,因此DistributedDatabase已经成为了最最迫切的需求。
DistributedDatabase是指Data在物理上分步而在逻辑上集中管理的Database系统。物理上分步是指DistributedDatabase的Data分步在物理位置不同并由网络连接的节点或站点上;逻辑上集中是指各Database节点之间在逻辑上是一个整体,并由统一的Database管理系统管理,不同的节点分步可以跨不同的机房、城市甚至国家。
DistributedDatabase的特点:
**透明性:**用户不必关系Data的逻辑分区和物理位置分步的细节,也不必关系重复副本的一致性Problem,同时不必关系在局部场地上Database支持哪种Data模型,对于Development工程师而言,当Database从一个场地移到另一个场地时必须改写应用程序,Usage起来如果一个Database。
**Data冗余性:**DistributedDatabase通过冗余Implementation系统的可靠性、可用性,并改善其Performance。多个节点StorageData副本,当某一个节点的Data遭到破坏时,冗余的副本可保证Data的完整性;当工作的节点受损害时,可通过心跳等Mechanism进行切换,系统整体不被破坏。还可以通过热点Data的就近分步原则减少网络通信的消耗,加快访问速度,改善Performance。
**易于扩展性:**在DistributedDatabase中能够方便地通过水平扩展提高系统的整体Performance,也能够通过垂直扩展来提高Performance,扩展并不需要修改系统程序。
**自治性:**各节点上的Data由本地的DBMS管理,具有自治处理能力,完成本场地的应用或局部应用
DistributedDatabase还具有经济、Performance优越、响应速度更快、灵活的体系结构、易于继承现有系统等特点。
3、分布式数据库的实现原理
DistributedDatabase具有逻辑整体性、物理Distributed,正是因为其物理分布性才使得DistributedDatabase的Implementation变得更加复杂,因为Data划分后Storage在不同的节点上,而为了保证可靠性,需要Storage多个副本,所以产生了Data复制的Problem。为了保证良好的Performance,DistributedDatabase必须易于扩展,具体来讲DistributedDatabase应有4个优势:Data Sharding及复制管理、具有Transaction的可靠性存取、良好的Performance、易于扩展,所以DistributedDatabase在Design上需要ImplementationDatabaseDatabase的Directory管理、Data Sharding、Distributed查询处理、DistributedConcurrency Control、Distributed Lock管理、DistributedStorage、Distributed网络架构、DistributedSafety管理等。
1、DistributedDatabase的Directory管理
DistributedDatabase的Directory存放着系统元Data及Database的元Data的全部信息,这些Data的存在是为了正确、有效地访问Data。Data的增删改查操作都需要用到Directory,用户授权、Safety管理及Concurrency Control等也都需要用到Directory,Directory结构的合理性直接影响Database的Performance。Directory一般包括各级的描述、访问Method的描述、关于Database的统计Data和一致性信息等,系统根据这些信息将用户查询转换为物理Database上的查询,Choose一条最佳的存取Path进行Transaction Management及Safety性、完整性检查等。
DistributedDatabase的Directory课分为全局Directory、DistributedDirectory、全局与本地混合Directory。
2、Data Sharding
当Database过于庞大,尤其是写入过于频繁且很难由一台主机支撑时,我们还是会面临扩展瓶颈。我们将存放在同一个DatabaseExample中的Data分散存放到多个DatabaseExample上,进行多台设备存取以提高Performance,在切分Data的同时可以提高系统整体的可用性。
Data Sharding是指将Data全局地划分为相关的逻辑片段,有水平切分、垂直切分、混合切分三种Type。
**水平切分:**按照某个字段的某种规则分散到多个节点Library中,每个节点中包含一部分Data。可以将Data的水平切分简单理解为按照Data行进行切分,就是将表中的某些行却分到一个节点,将另外某些行切分到其他节点,从Distributed的整体来看它们是一个整体的表
**垂直切分:**一个Database由很多表构成,每个表对应不同的业务,垂直切分是指按照业务将表进行分类并分不到不同的节点上,垂直拆分简单明了,拆分规则明确,应用程序模块清晰、明确、容易整合,但是某个表的Data量达到一定程度后扩展起来比较困难。
**混合切分:**水平切分和垂直切分的结合
3、Distributed查询处理
Distributed查询处理的任务就是把一个DistributedDatabase上的高层次查询映射为在本地Database上的操作,查询的Analysis必须拆分为代数查询的关系运算序列,将要查询的Data定位到各节点,使得查询在各节点进行,最后通过网络通信的操作汇聚查询结果。
4、DistributedConcurrency Control
Concurrency Control是Distributed Transaction管理的基本任务之一,其目的是保证DistributedDatabase中的多个TransactionConcurrency高效、正确的Execute。Concurrency Control用来保证Transaction的可串行性,也就是说Transaction的ConcurrencyExecute等价于它们按某种次序的串行Execute,从而为用户提供Concurrency的透明性。进行Concurrency Control的Method主要有三种:加LockConcurrency Control、时间戳控制、乐观Concurrency Control。加LockConcurrency Control应用广泛,但是容易发生Deadlock;时间戳控制消除了Deadlock,一旦发生Conflict变回Restart而不是等待,需要有全局的统一时钟;乐观Concurrency Control对于Conflict较少的系统较为合适,对于Conflict多的系统则效率低下。
4、OLTP和OLAP
在互联网时代,海量Data的Storage和访问成为System Design与Usage的瓶颈,对于海量Data处理,按照Usage场景,主要分为两种Type:联机Transaction处理(OLTP)和联级分析处理(OLAP)。
联机Transaction处理也称为面向Transaction的处理系统,其基本特征是原始Data可以立即传送到计算中心进行处理,在很短的时间内给出处理结果。
联级分析处理是指通过多维的方式对Data进行分析、查询和报表,可以同Data挖掘Tools、统计分析Tools配合Usage,增强决策分析功能。
两者之间的区别:
| OLTP | OLAP | |
|---|---|---|
| 系统功能 | 日常交易处理 | 统计、分析、报表 |
| DBDesign | 面向实时交易类应用 | 面向统计分析类应用 |
| Data处理 | 当前的,最新的细节的, | 历史的、聚集的、多维的、集成的 |
| 实时性 | 实时读写要求高 | 实时要求读写低 |
| Transaction | Strong Consistency | 弱Transaction |
| 分析要求 | 低,简单 | 高,复杂 |
5、关系型数据库和NoSQL
关系型Database是建立在关系模型Basic上的Database,其借助于集合代数等数学概念和Method来处理Database中的Data,主流的是Oracle,DB2,SQL Server,MySQL
NoSQLDatabase,全称为Not Only SQL,意思就是适用关系型Database的时候就是用关系型Database,不适用的时候也没必要非Usage关系型Database不可,可以考虑更加合适的Data Storage,主要分为临时性键值Storage(Memcached,Redis),永久性键值Storage(Redis),面向文档的Database(MongoDB,CouchDB),面向列的Database(Cassandra,HBase),每种NoSQL都有其特有的Usage场景及优点。
| 关系型Database | NoSQLDatabase | |
|---|---|---|
| 特点 | Data关系模型基于关系模型,结构化Storage,完整性Constraints 基于二维表及其之间的联系,需要连接、并、交、差等操作 采用结构化的查询语言做Data读写 操作需要Data的一致性,需要Transaction甚至Strong Consistency | 非结构化的Storage 基于多维关系模型 具有特色的Usage场景 |
| 优点 | 保证Data的一致性 可以进行join等复杂查询 通用化,技术成熟 | 高Concurrency、Big Data下读写能力强 支持Distributed,易于扩展,可伸缩 简单,弱结构化Storage |
| 缺点 | Data读写必须经过sqlAnalysis,大量Data、高Concurrency读写Performance不足 对Data做读写,或修改Data结构时需要加Lock,影响Concurrency操作 无法适应非结构化Storage 扩展困难 昂贵、复杂 | join等复杂操作能力较弱 Transaction支持较弱 通用性差 无完整Constraints复杂业务场景支持较差 |
二、MyCat介绍
1、MyCat是什么
MyCat 是什么?从定义和分类来看,它是一个开源的DistributedDatabase系统,是一个Implementation了 MySQL 协议的Server,前端用户可以把它看作是一个DatabaseProxy,用 MySQL 客户端Tools和Command行访问,而其后端可以用MySQL 原生(Native) 协议与多个 MySQL Server通信,也可以用 JDBC 协议与大多数主流DatabaseServer通信,其核心功能是分表分Library,即将一个大表水平分割为 N 个小表,Storage在后端 MySQL Server里或者其他Database里。 MyCat 发展到目前的Version,已经不是一个单纯的 MySQL Proxy了,它的后端可以支持 MySQL、 SQL Server、Oracle、 DB2、 PostgreSQL 等主流Database,也支持 MongoDB 这种新型 NoSQL 方式的Storage,未来还会支持更多Type的Storage。而在最终用户看来,无论是那种Storage方式,在 MyCat 里,都是一个传统的Database表,支持标准的SQL 语句进行Data的操作,这样一来,对前端业务系统来说,可以大幅降低Development难度,提升Development速度,在Test阶段,可以将一个表定义为任何一种 MyCat 支持的Storage方式,比如 MySQL 的 MyASIM 表、内存表、或者MongoDB、 LevelDB 以及号称是世界上最快的内存Database MemSQL 上。试想一下,用户表存放在 MemSQL 上,大量读频率远超过写频率的Data如订单的快照Data存放于 InnoDB 中,一些LoggingData存放于 MongoDB 中,而且还能把 Oracle 的表跟 MySQL 的表做关联查询,你是否有一种不能呼吸的感觉?而未来,还能通过 MyCat 自动将一些计算分析后的Data灌入到 Hadoop 中,并能用 MyCat+Storm/Spark Stream 引擎做大规模Data Analysis,看到这里,你大概明白了, MyCat 是什么? MyCat 就是 BigSQL, Big Data On SQL Database。
对于不同的角色,MyCat到底是个啥?
对于DBA而言,可以这么理解MyCat:
MyCat就是MySQL Server,而Mycat后面连接的MySQL Server,就好像是MySQL的Storage引擎,如InnoDB,MyISAM等,因此,MyCat本身并不StorageData,Data是再后端的MySQL上Storage的,因此Data可靠性以及Transaction都是MySQL保证的,简单说,MyCat就s是MySQL最佳伴侣,它再一定程度上让MySQL拥有了能跟Oracle PK的能力。
对于软件工程师来说,可以这么理解MyCat:
MyCat就是一个近似等于MySQL的DatabaseServer,你可以用连接MySQL的方式去连接MyCat,除了端口不同,默认的MyCat端口是8066而不是MySQL的3306,因此需要再连接字符串上增加端口信息,大多数情况下,可以用你熟悉的对象映射FrameworkUsageMyCat,但建议对于分片表,尽量UsageBasic的SQL语句,因为这样能达到最佳Performance,特别是几千万甚至几百亿条记录的情况下。
对于Architect来说,可以这么理解MyCat:
MyCat是一个强大的Database中间件,不仅仅可以用作Read-Write Separation、以及分Library分表、Disaster Recovery and Backup,而且可以用于多租户应用Development,云平台Basic设施,让你的架构具备很强的适应性和灵活性,借助于即将Publish的mycat只能Optimization模块,系统的Data访问瓶颈和热点一目了然,根据这些统计分析Data,你可以自动或手工调整后端Storage,将不同的表映射到不同的Storage引擎上,而整个应用的Code一行也不用改变。
2、MyCat的原理
MyCat的Principle并不复杂,复杂的是Code,如果Code也不复杂,那么早就成为了一个传说了。
MyCat的Principle中最重要的一个动作是“拦截”,它拦截了用户发送过来的SQL语句,首先对SQL语句做了一些特定的分析:如分片分析、路由分析、Read-Write Separation分析、Cache分析等,然后将此SQL发送后端的真实Database,并将Return的结果做适当的处理,最终再Return给用户。
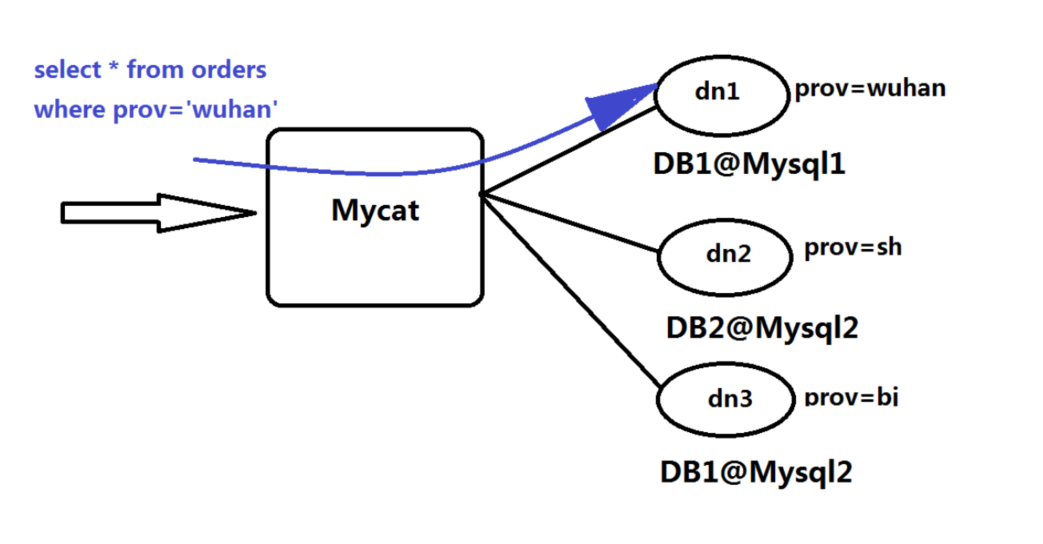
上述图片里,orders表被分为了三个分片DataNode(简称dn),这三个分片是分布在两台MySQL Server上(Datahost),即datanode=database@datahost方式,因此你可以用一台到N台Server来分片,分片规则为(sharding rule)典型的字符串枚举分片规则,一个规则的定义是分片字段(sharding column)+分片Function(rule function),这里的分片字段为prov而分片Function为字符串枚举方式。
当MyCat收到一个SQL时,会先Analysis这个SQL,查找涉及到的表,然后看此表的定义,如果有分片规则,则Get到SQL里分片字段的值,并分配分片Function,得到该SQL对应的分片列表,然后将SQL发往这些分片去Execute,最后收集和处理所有分片Return的结果Data,并输出到客户端,以select * from orders where prov = ?语句为例,查到prov=wuhan,按照分片Function,wuhanReturndn1,于是sql就发给了mysql1,去取db1上的查询结果,并Return给用户。
如果上述sql改为select * from orders where prov in (wuhan,beijing),那么,sql就会发给MySQL1和MySQL2去Execute,然后结果集合并后输出给用户。但通常业务中我们的SQL会有order by以及limit翻页Syntax,此时就Design到结果集在MyCat端的二次处理,这部分Code也比较复杂,而最复杂的则属两个表的join,为此,MyCat提出了创新性的ER分片,全局表,HBT(human brain tech)Artificial Intelligence的Catlet,以及结合Storm/Spark引擎等十八般武艺的解决办法,从而称为目前业界最强大的方案,这就是开源的力量。
3、应用场景
MyCat发展到现在,Usage的场景已经很丰富,而且不断有新用户给出新的创新性的方案,以下是典型的应用场景:
1、单纯的Read-Write Separation,此时Configuration最为简单,支持Read-Write Separation,主从切换
2、分Library分表,对于超过1000万的表进行分片,最大支持1000亿的单表分片
3、多租户应用,每个应用一个Library,但应用程序只连接MyCat,从而不改造程序本身,Implementation多租户化
4、报表系统,借助MyCat的分表能力,处理大规模报表的统计
5、整合多Data源
6、作为海量Data实时查询的一种简单有效方案,比如100亿条频繁查询的记录需要在3秒内查询出来结果,除了基于主键的查询,还可能存在范围查询或其他属性查询,此时MyCat可能是最简单有效的Choose
7、Database路由器,MyCat基于MySQLExample的Connection Pool复用Mechanism,可以让每一个应用最大程度地共享一个MySQLExample的所有Connection Pool,让Database的Concurrency访问能力大大提升
4、为什么使用MyCat
1、java与Database紧耦合
2、高访问量高Concurrency对Database的压力
3、读写请求Data不一致
5、数据库中间件对比
| 对比项目 | mycat | mango | cobar | heisenberg | altas | amoeba |
|---|---|---|---|---|---|---|
| Data切片 | 支持 | 支持 | 支持 | 支持 | 支持 | 支持 |
| Read-Write Separation | 支持 | 支持 | 支持 | 支持 | 支持 | 支持 |
| 宕机自动切换 | 支持 | 不支持 | 支持 | 不支持 | 半支持,影响写 | 不支持 |
| mysql协议 | 前后端支持 | JDBC | 前端支持 | 前后端支持 | 前后端支持 | JDBC |
| 支持的Database | mysql,oracle,mongodb,postgresql | mysql | mysql | mysql | mysql | mysql,mongodb |
| 社区活跃度 | 高 | 活跃 | 停滞 | 低 | 中等 | 停滞 |
| 文档资料 | 极丰富 | 较齐全 | 较齐全 | 较少 | 中等 | 缺少 |
| 是否开源 | 开源 | 开源 | 开源 | 开源 | 开源 | 开源 |
| 是否支持Transaction | 弱XA | 支持 | 单Library强一致,Distributed弱Transaction | 单Library强一致,多Library弱Transaction | 单Library强一致,分布弱Transaction | 不支持 |
三、MyCat的核心概念
MyCat是Database中间件,就是介于Database与应用之间,进行Data处理和交互的中间Service。从原有的一个Library,被切分为多个分片Database,所有的分片Database集群构成了整个完整的DatabaseStorage。
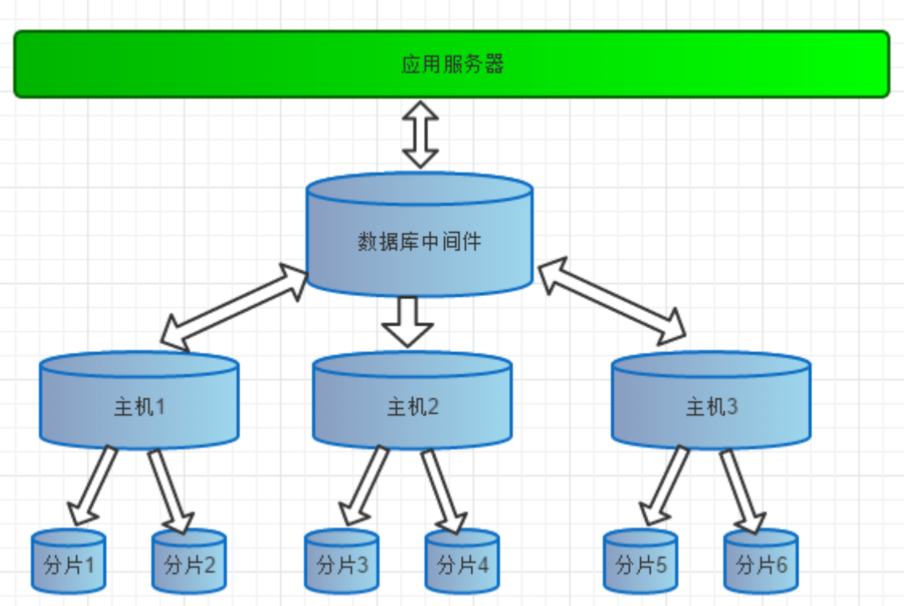
如上图所示,Data被分到多个分片Database之后,应用如果需要读取Data,就要处理多个Data源的Data。如果没有Database中间件,那么应用将直接面对分片集群,Data源切换、Transaction处理、Data聚合都需要应用直接处理,原本该是专注于业务的应用,将会话大量的工作来处理分片后的Problem,最重要的是每个应用处理将是完全的重复造轮子。
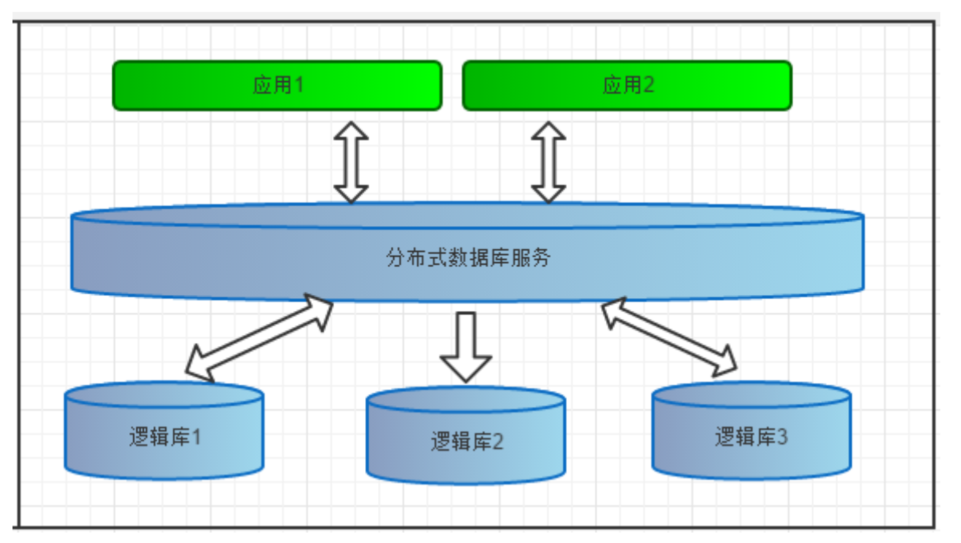
1、逻辑库
对于实际应用而言,其实并不需要知道中间件的存在,Development人员只需要知道Database的概念即可,所以Database中间件可以被看作是一个或多个Database集群构成的逻辑Library。
在云计算时代,Database中间件可以以多租户的形式给一个或多个应用提供Service,每个应用访问的可能是一个独立或者共享的物理Library,常见的如阿里云DatabaseServerRDS
2、逻辑表
既然有逻辑Library,那么就应该有逻辑表,在DistributedDatabase中,对应用来说,读写Data的表就是逻辑表。逻辑表可以使Data切分后,分步在一个或多个分片Library中,也可以不做Data切分,不分片,只有一个表构成
3、分片表
分片表,是指哪些原有的很Big Data的表,需要切分到多个Database的表,这样每一个分片都会有一部分Data,所有分片构成了完整的Data。
4、非分片表
一个Database中并不是所有的表都很大,某些表是可以不用进行切分的,非分片是相对分片表来说的,就是那些不需要进行Data切分的表。
5、ER表
关系型Database是基于实体关系模型之上,通过其描述了真实世界中事物与关系,MyCat中的ER表既是来源于此。根据这一思路,提出了基于ER关系的Data Sharding策略,子表的记录与所关联的父表记录存放在同一个Data Sharding上,即子类Dependency于父类,通过表分组保证Datajoin不会跨Library操作。
表分组是解决跨分片Datajoin的一种很好的思路,也是Data切分规划的重要一条规则。
6、全局表
一个真实的业务系统中,往往存在大量的类似字典表的表,这些表基本上很少变动,字典表具有以下几个特点:
1、变动不频繁
2、Data量总体变化不大
3、Data规模不大,很少有超过数十万条记录
对于这类的表,在分片的情况下,当业务表因为规模而进行分片以后,业务表与这些附属的字典表之间的关联,就成了比较棘手的Problem,所以MyCat中通过Data冗余来解决这类表的join,即所有的分片都有一份Data的拷贝,所有将字典表或者符合字典表Features的一些表定义为全局表。
Data冗余是解决跨分片Datajoin的一种很好思路,也是Data切分规划的另外一条重要原则
7、分片节点(dataNode)
Data切分后,一个大表被分到不同的分片Database上面,每个表分片所在的Database就是分片节点(dataNode)
8、节点主机(dataHost)
Data切分后,每个分片节点(dataNode)不一定都会独占一台机器,同一机器上面可以有多个分片Database,这样一个或多个分片节点(dataNode)所在的机器就是节点主机(dataHost),为了规避单节点主机Concurrency数限制,尽量将读写压力高的分片节点(dataNode)均衡的放在不同的节点主机(dataHost)。
9、分片规则
Data切分是指一个大表被分成若干个分片表,就需要一定的规则,这样按照某种规则把Data分到某个分片的规则就是分片规则,Data切分Choose合适的分片规则非常重要,将极大的避免后续Data处理的难度。
10、全局序列号
Data切分后,原有的关系Database中的主键Constraints在Distributed条件下将无法Usage,因此需要引入外部Mechanism保证Data唯一性标识,这种保证全局性的Data唯一标识的Mechanism就是全局序列号。
11、多租户
多租户技术或称多重租赁技术,是一种软件架构技术,它是在探讨与Implementation如何于多用户的环境下共用相同的系统或程序组件,并且扔可确保各用户间Data的隔离性。在云计算时代,多租户技术在共用的Data中心以单一System Architecture与Service提供多数客户端相同甚至可定制化的Service,并且仍然可以保障客户的Data隔离。目前各种各样的云计算Service就是这类技术范畴,例如阿里云DatabaseService(RDS),阿里云Server等等。
多租户在Data Storage上存在三种主要的方案,分别是:
1、独立数据库
一个租户一个Database,这种方案的用户DataIsolation Level最高,Safety性最好,但成本也高。
优点:为不同的租户提供独立的Database,有助于简化Data模型的扩展Design,满足不同租户的独特需求,如果出现故障,恢复Data比较简单。
缺点:增大了Database的Installation数量,随之带来维护成本和购置成本的增加
2、共享数据库,隔离数据架构
多个或者所有租户共享database,但是每一个租户一个schema
优点:为Safety性要求较高的租户提供了一定程度的逻辑Data隔离,并不是完全隔离;每个Database可以支持更多的租户数量
缺点:如果出现故障,Data Recovery比较困难,因此恢复Database将牵扯到其他租户的Data,如果需要跨租户统计Data,存在一定困难
3、共享数据库,共享数据结构
租户共享同一个database,同一个schema,但在表中通过tenantID区分租户的Data。这是共享程度最高、Isolation Level最低的Pattern
优点:维护和购置成本最低,Run每个Database支持的租户数量最多
缺点:Isolation Level最低,Safety性最低,需要在DesignDevelopment时加大对Safety的Development量,DataBackup和恢复最困难,需要逐表逐条Backup和还原。